12:30谷歌Gemini造假风波完整盘点:演示视频造假?测评放水?Bard垃圾?|AI进化论-花生
围绕Gemini初次发布后的争议,本期分别讨论演示视频的制作方式、评测提示条件差异,以及Bard中实际可用模型的体验。花叔指出剪辑演示不能直接当作实时交互表现,并用部分相同图片和提示词测试GPT-4V;在基准比较中,他强调不同提示方法会影响成绩。最后更正上一期对Bard使用条件的演示,并对联网问答作比较,主张等待实际产品表现再判断模型优劣。
花叔的工作台 / 视频手记
AI工具实测、独立开发与内容创作。先看要点,感兴趣再看完整实践。
全部视频 146条
12:30围绕Gemini初次发布后的争议,本期分别讨论演示视频的制作方式、评测提示条件差异,以及Bard中实际可用模型的体验。花叔指出剪辑演示不能直接当作实时交互表现,并用部分相同图片和提示词测试GPT-4V;在基准比较中,他强调不同提示方法会影响成绩。最后更正上一期对Bard使用条件的演示,并对联网问答作比较,主张等待实际产品表现再判断模型优劣。
15:27本期在Gemini首次发布后介绍其多模态定位,区分Ultra、Pro与Nano,并说明录制当时能体验的主要是Pro。作者对「超过GPT-4」的说法提出评测方式、任务差异、安全调整和工具生态等疑问,主张等待实际产品表现。后半段收录Google官方演示,展示画图识别、游戏、物体关系与视频场景理解等可能用途。
16:31花叔以文学翻译为例,设计「翻译、校对、润色」三阶段提示词,把任务目标、专家职责与输出顺序写清楚,并用Markdown组织结构。核心做法是让每个阶段都产出文本,使后续步骤能够回看并修改前一步的结果。视频随后将不同来源的译文匿名交给多个模型比较,讨论上下文对评分的影响。它提供的是复杂任务拆分与迭代的方法,展示结果来自有限样例。
3:59本期记录2023年11月Sam Altman被OpenAI董事会解雇消息刚公布时的反应。视频阅读当时的官方声明,介绍临时管理安排、董事会给出的沟通理由,以及联合创始人Greg相关职务变化。后半段转述社交平台对事件原因的不同猜测,包括微软因素和带有玩笑性质的AGI说法;这些推测在视频中并未得到证实。
12:30花叔围绕当时流传的一组ChatGPT系统提示词展开拆解,讨论聊天产品如何通过指令组织回复风格和图像工具调用。教程从中提炼出几种可迁移的写法:把模糊要求变成明确条件,用编号拆开规则,提供少量示例,并根据常见任务和个人背景设计自定义指令。视频也表达了对提示词与模型微调适用范围的看法,主要价值在于观察具体指令如何写得更清楚。
30:22视频通过21个例子探索GPT-4V图像理解在旅行、生活、工作和学习中的用法,包括识别景点与菜单、提供设计反馈、解读图表、从截图生成网页以及辅助阅读。演示也呈现了边界:图表主题可能被误读,截图生成的页面与原图仍有差异,书架分析会作出未经证实的推断。这些案例主要帮助寻找可尝试的视觉辅助场景,不能据此把模型输出视为已核实事实。
10:13本期从语言模型的输出特点出发,解释ChatGPT「自定义指令」如何减少每轮对话中重复交代背景和要求的成本。作者建议回顾自己的聊天记录,归纳常见任务、身份信息和回答偏好,再编写适合自身的全局指令。视频以主题讨论、文本生成、问题咨询与代码沟通四类场景示范,强调按用途提炼规则,而非照抄他人的单一模板。
5:07花叔介绍微软与LinkedIn推出的生成式AI学习课程,说明当时的学习入口、模块内容、进度记录和考试取证流程。课程涵盖生成式AI基础、搜索方式变化、Bing Chat工作应用、AI伦理及人工智能原理。视频结合自己的学习与考试经历,展示完成课程后如何把证书放入职业资料,并提醒要真正看完各部分内容;证书的职业价值属于作者当时的个人判断。
18:20本期从一段市值比较文字的形成过程出发,对照人类查资料、计算、反思和修改,与语言模型逐步生成文本的差别,解释为何不能用单一问答把AI判断为「全能」或「愚蠢」。围绕当时的ChatGPT,视频给出补充背景知识、连接工具、复核答案、拆分复杂任务、提供示例和指定专业视角等方法,核心是理解模型的能力边界,再设计合适的协作方式。
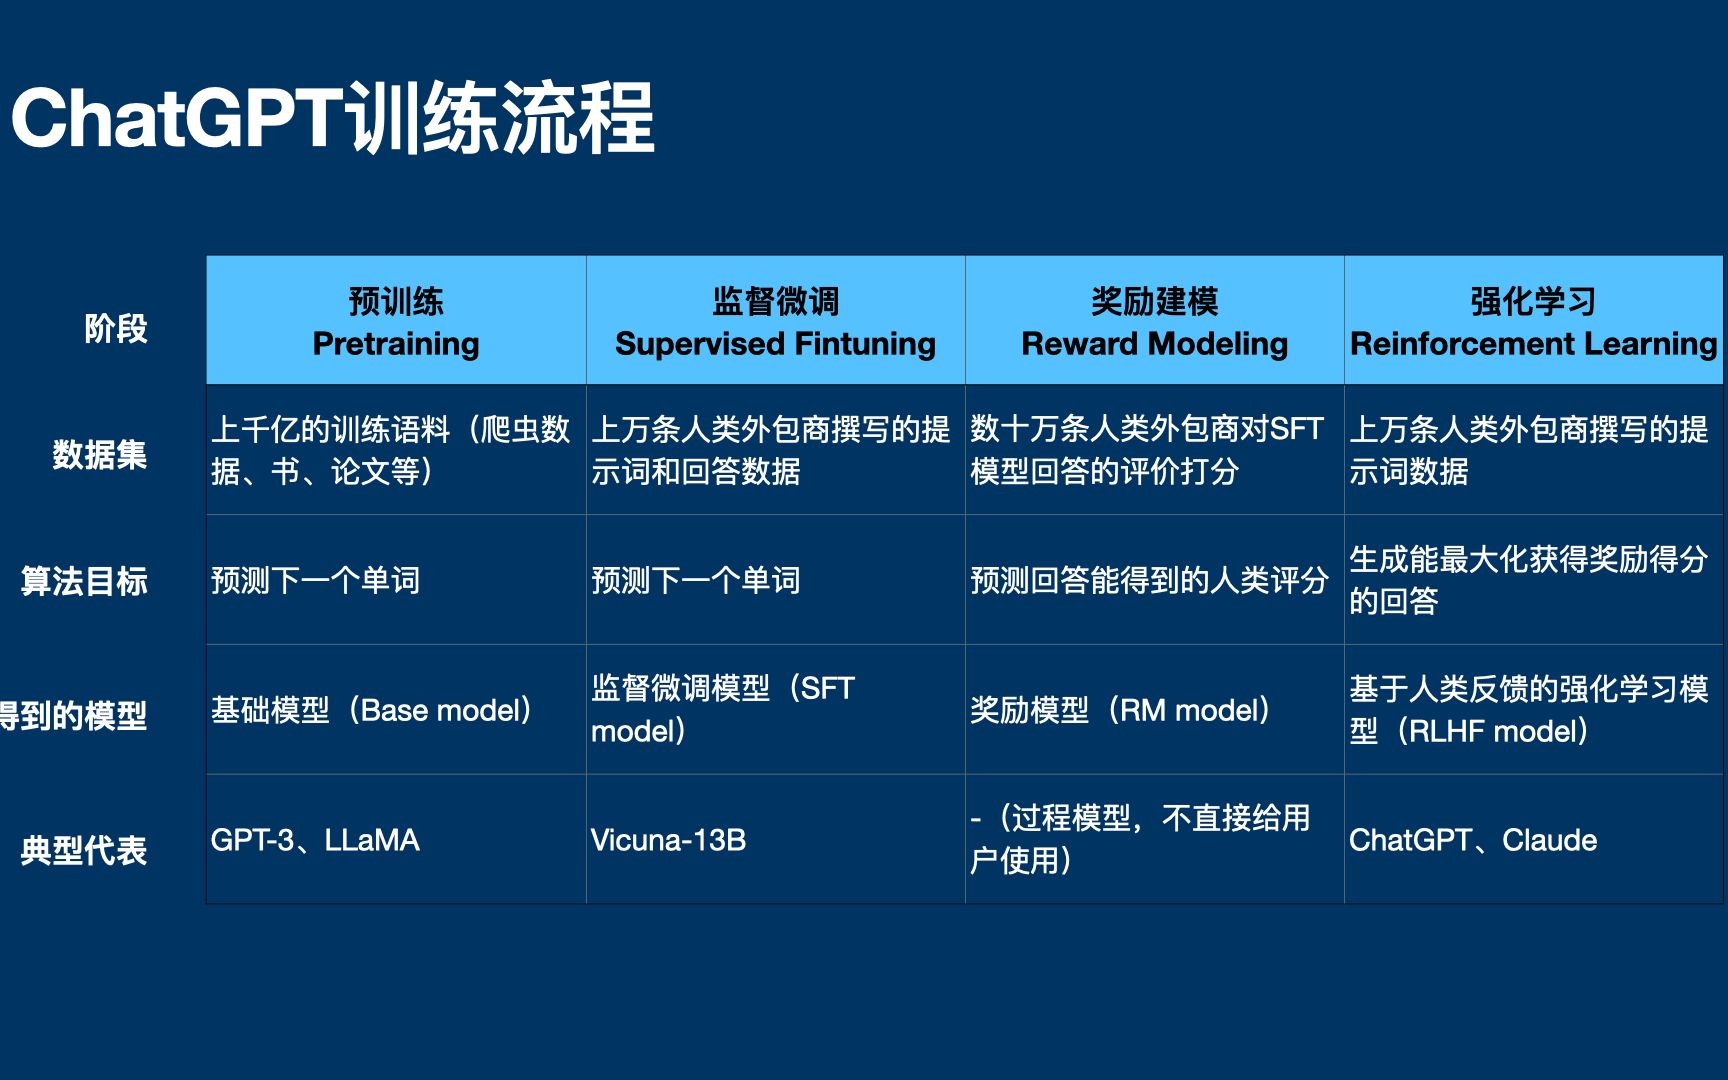
27:57本期面向普通用户解释ChatGPT的典型训练流程:预训练、监督微调、奖励建模与强化学习。视频从语料构成、Token和预测下一个词讲起,区分基础模型的续写行为与助手式回答,再说明人类示例、偏好排序和奖励信号如何影响输出。作者希望通过理解训练目标,帮助用户认识模型的优势与局限,并为选择模型和编写提示词建立基础。
13:00本期系统演示早期ChatGPT的代码解释器、网页浏览和第三方插件。代码案例涵盖豆瓣观影数据分析、Python纠错、图片压缩、视频转GIF、批量文件处理、插件打包与动态二维码;联网部分展示行情、赛事和论文查询,第三方插件则用于机票与酒店搜索。视频保留了报错、搜索失败和地点错误,并通过继续沟通修正结果。
17:10这是花叔离开互联网大厂初期的个人记录。他分享边旅居边学习AI、通过付费专栏获得约3000元收入的经历,也坦言当时收入不足以覆盖正常生活。视频借此反思「靠AI快速赚百万」的叙事:已有受众、渠道和行业能力往往比工具本身更关键。他计划继续做内容、借AI实现产品想法,并给自己时间尝试,强调创造别人需要的东西和亲自实践,而非追逐短期承诺。
11:25本期借Vidu演示七个AI视频入门技巧:用主体、动作、场景和镜头风格组织提示词,通过主体参考保持人物一致,设置首尾帧定义动作起止,再尝试动画风格、模板、音效和专业提示词模式。视频围绕同一女武士形象反复改变场景,帮助理解文字控制与参考素材的分工,也介绍配套提示词网站。目标是完成第一段短片并逐步改善连贯性,效果以当期展示样例为准。
2:26在Sora首次发布的当天,花叔介绍OpenAI公布的文字生成视频样片,关注东京街景中的人物运动与倒影、奔跑的猛犸象、雪地宇航员和艺术画廊等画面。他通过这些片段谈当时对视频长度、场景细节与镜头变化的直观感受,并明确说明模型尚未向普通用户开放。内容是一则基于发布样片的即时观察,保留了AI视频生成进入新阶段时的第一现场反应。
10:28花叔用ChatGPT接入DALL·E 3后的早期体验,展示自然语言如何参与图片创作。他从背包海报出发,尝试去背景、改颜色和添加品牌文字,再用古诗与《小王子》场景生成插图。案例中既能看到对话帮助补充需求、保留部分风格的便利,也能看到改图时造型变化和中文文字失真的限制。视频最后补充当时另一种体验入口,整体侧重普通用户的创作流程。


公开视频提供字幕整理的摘要与章节;充电专属内容请到B站查看。